Trang chủ / Độ tin cậy hệ thống
Chẩn đoán CrashLoopBackOff trong Kubernetes pod từng bước
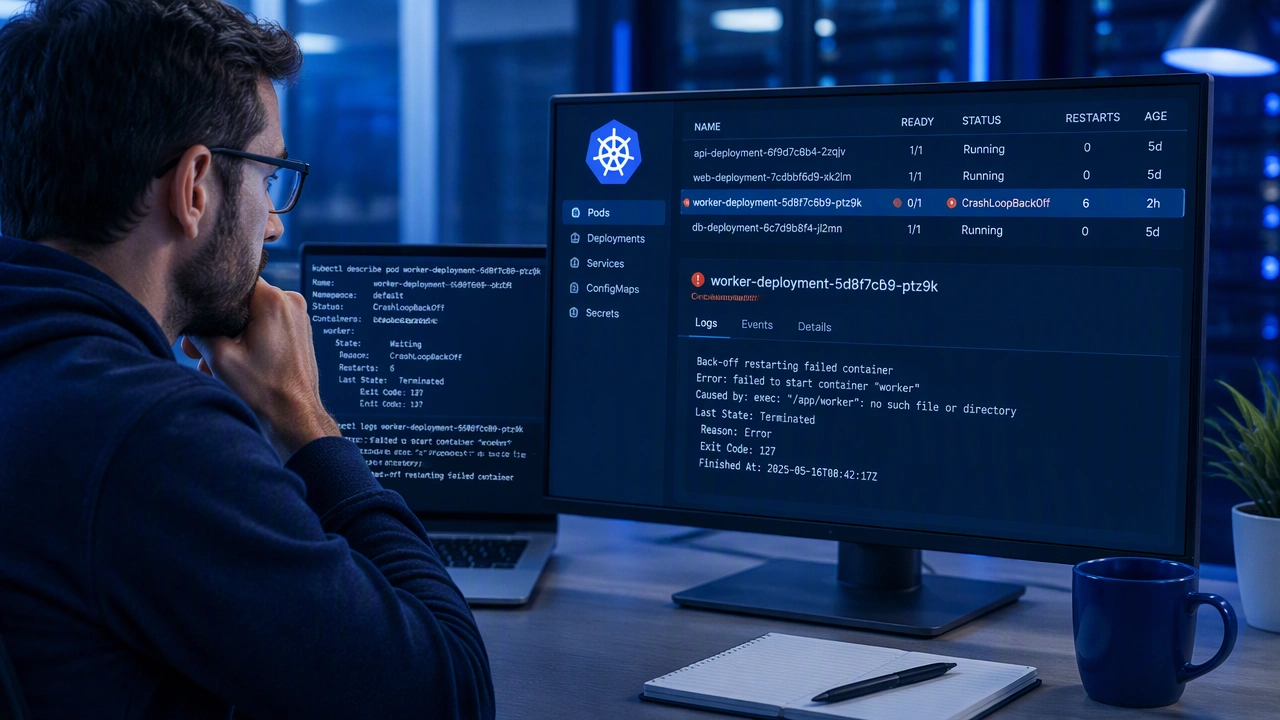
CrashLoopBackOff là một trong những tín hiệu phổ biến nhất cho thấy có vấn đề với workload trên container. Nghĩa là container đã khởi chạy rồi thoát, và Kubernetes đang trì hoãn lần khởi động lại tiếp theo để tránh một vòng lặp restart liên tục. Với các nhóm quản trị hệ thống đang vận hành dịch vụ, trạng thái này hữu ích vì nó chỉ ra một lỗi cụ thể, nhưng thông báo bản thân hiếm khi giải thích nguyên nhân. Việc restart là kết quả; bằng chứng thường nằm ở nơi khác.
Hướng dẫn này giải thích cách chẩn đoán CrashLoopBackOff trong Kubernetes pod từng bước, sử dụng logs, events, trạng thái output và kiểm tra cấu hình theo một trình tự có chủ đích.
Xác nhận triệu chứng và lưu trạng thái hiện tại
Bắt đầu bằng cách xác định chính xác workload và pod. Ghi lại namespace, tên pod, số lần restart, phase hiện tại và số lần container đã khởi chạy. Pod có thể đã được tạo lại bởi Deployment hoặc ReplicaSet, nên sử dụng tên workload ổn định khi điều tra lịch sử thay vì chỉ dựa vào một tên pod tạm thời.
Trước khi thay đổi bất kỳ điều gì, lưu lại trạng thái bạn đang thấy. Lưu output của pod description, trạng thái container và các sự kiện gần đây. Nếu pod đang liên tục được tạo lại, ghi lại thời gian khởi chạy và thoát để có thể đối chiếu với các sự kiện của ứng dụng và nền tảng.
Kiểm tra trạng thái pod và các state của container
Xem lý do và thông báo Waiting cho mỗi container. Lý do có thể là CrashLoopBackOff, nhưng sidecar, init container hoặc ephemeral container cũng có thể là thành phần gặp lỗi. Kiểm tra mã thoát, signal và thời gian dừng lần cuối. Một thoát bình thường với mã khác 0 cho thấy ứng dụng tự kết thúc; một signal thường chỉ ra việc dừng từ bên ngoài hoặc một điều kiện runtime nghiêm trọng.
Chú ý xem container có đạt trạng thái ready trước khi restart không. Một container trở thành ready rồi sau đó thoát thì khác với một container thất bại trong quá trình khởi động.
Đọc logs để giải thích lý do thoát
Logs là nguồn bằng chứng ở cấp ứng dụng đầu tiên. Yêu cầu cả logs hiện tại và logs từ lần chạy container trước đó. Logs trước đó quan trọng vì lần chạy thất bại có thể đã tạo ra lỗi hữu ích duy nhất trước khi tiến trình biến mất.
Thu thập logs hiện tại và trước đó
Sử dụng tên container một cách rõ ràng khi pod có nhiều container. Xem các dòng cuối cùng trước khi dừng, cùng với các cảnh báo và stack trace. Tìm các file bị thiếu, giá trị không hợp lệ, kết nối bị từ chối, xác thực thất bại và các exception chưa được xử lý.
Nếu logs kết thúc đột ngột mà không có lỗi ứng dụng, hãy cân nhắc xem tiến trình có bị dừng trước khi kịp flush output không. Mẫu này chuyển sự chú ý sang các probe, giới hạn resource hoặc việc dừng ở cấp nền tảng.
Phân biệt lỗi khởi động và lỗi runtime
Phân loại những gì bạn tìm thấy. Lỗi khởi động thường bao gồm thiếu cấu hình, tham số lệnh không hợp lệ, không tương thích cơ sở dữ liệu hoặc cổng đã bị chiếm. Lỗi runtime có thể chỉ ra áp lực bộ nhớ, phụ thuộc bị ngừng hoạt động hoặc sự cố sau khi xử lý yêu cầu đầu tiên. Thời điểm thoát giúp xác định hướng điều tra phù hợp.
Sử dụng Kubernetes events như một dòng thời gian
Events cho thấy control plane và kubelet đã quan sát được gì xung quanh mỗi lần restart. Xem xét các sự kiện scheduled, pulled, created, started, failed và back-off cùng nhau. Một mô hình lặp lại của việc tạo rồi thoát nhanh thường có nghĩa là ứng dụng gặp lỗi rất sớm. Việc khởi chạy chậm có thể chỉ ra việc kéo image, áp lực trên node hoặc ràng buộc resource.
Kiểm tra các probe thất bại và tác nhân gây restart
So sánh các probe thất bại với thời gian restart. Nếu readiness hoặc liveness probe thất bại, nền tảng có thể cố tình restart container. Một liveness probe với timeout quá chặt hoặc đường dẫn yêu cầu một phụ thuộc chạy chậm có thể biến một tiến trình khỏe mạnh thành vòng lặp restart. Xác minh đường dẫn, cổng, độ trễ ban đầu, timeout, khoảng thời giới và ngưỡng thất bại của probe.
Tìm kiếm áp lực từ node và resource
Kiểm tra tình trạng node, áp lực ổ đĩa, áp lực bộ nhớ và các request hoặc limit resource của pod. Việc dừng do hết bộ nhớ (OOM) có thể trông giống một sự cố ứng dụng ngay cả khi mã nguồn hoàn toàn đúng. So sánh thời gian restart container với các sự kiện node và các thay đổi lập lịch gần đây.
Xác minh cấu hình trước khi thay đổi mã nguồn
Nhiều vòng lặp restart là do vấn đề cấu hình chứ không phải lỗi trong ứng dụng. Xem xét các biến môi trường, file được mount, tham chiếu secrets và các tham số lệnh như chúng thực sự được render trong pod.
Kiểm tra biến môi trường và file được mount
Xác nhận rằng các biến cần thiết tồn tại, được viết đúng và chứa giá trị có thể sử dụng. Kiểm tra rằng secrets và config map được tham chiếu tồn tại trong cùng namespace và các đường dẫn mount khớp với những gì ứng dụng mong đợi. Quyền truy cập file, JSON hoặc YAML bị lỗi định dạng và thông tin xác thực hết hạn là những nguyên nhân phổ biến gây ra thoát ngay lập tức.
Xem xét image, lệnh và tham số
Xác minh rằng tag image là phiên bản dự kiến và image có thể chạy trên kiến trúc node đã chọn. Xác nhận rằng entrypoint và các tham số không bị thay đổi. Một image đúng nhưng với working directory, shell hoặc lệnh sai có thể thất bại trước khi ứng dụng khởi chạy.
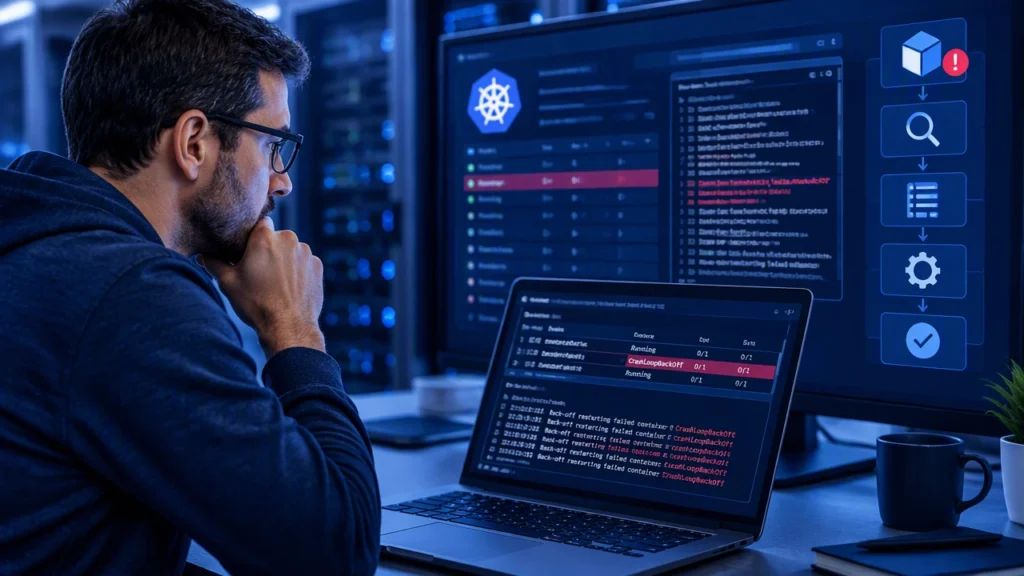
Truy vết lý do thoát bằng một quy trình ra quyết định có cấu trúc
Sử dụng bằng chứng để thu hẹp nguyên nhân theo thứ tự:
- Thoát ngay sau khi khởi chạy: kiểm tra cấu hình, secrets, lệnh của image và các phụ thuộc khởi động.
- Probe thất bại trước khi restart: điều chỉnh thời gian probe hoặc sửa endpoint, sau đó xác minh readiness riêng biệt với liveness.
- Hết bộ nhớ hoặc bị trục xuất: so sánh limit và usage, kiểm tra áp lực node, và xem xét lưu lượng truy cập hoặc các thay đổi batch gần đây.
- Phụ thuộc không khả dụng: xác minh DNS, network policy, service endpoint, di chuyển cơ sở dữ liệu và thông tin xác thực bên ngoài.
- Lỗi quyền hoặc hệ thống file: xác thực security context, user ID, volume mount và quyền sở hữu file.
Thay đổi nhỏ và xác minh phục hồi
Thay đổi một biến tại một thời điểm. Sau khi sửa cấu hình hoặc hành vi probe, quan sát số lần restart, readiness, logs và events qua một vài chu kỳ restart. Phục hồi được xác nhận khi container tiếp tục chạy, vượt qua các kiểm tra readiness và ngừng tạo ra các sự kiện dừng.
Giữ bằng chứng đã thu thập cùng với hồ sơ sự cố. Sự kết hợp của logs trước đó, lý do dừng, thời điểm events và các bản chụp cấu hình biến một vòng lặp restart lặp đi lặp lại thành một vấn đề vận hành có thể chẩn đoán thay vì một phỏng đoán.