Trang chủ / Mạng và khả năng quan sát
Khắc phục lỗi đầy ổ đĩa trên Linux: hướng dẫn dựa trên bằng chứng cho quản trị hệ thống
Trong vận hành IT, cảnh báo đầy ổ đĩa rất thường gặp, nhưng cách xử lý đúng không phải là xóa file ngẫu nhiên. Chẩn đoán dựa trên bằng chứng bắt đầu bằng việc xác nhận sự cố, xác định filesystem bị ảnh hưởng, sau đó thu hẹp phạm vi từ điểm mount đến thư mục hoặc file đang chiếm dung lượng. Bài viết này trình bày quy trình đó theo thứ tự, kèm các lệnh đáng tin cậy và những bước kiểm tra giúp tránh sai lầm phổ biến.
Xác nhận sự cố và filesystem mục tiêu
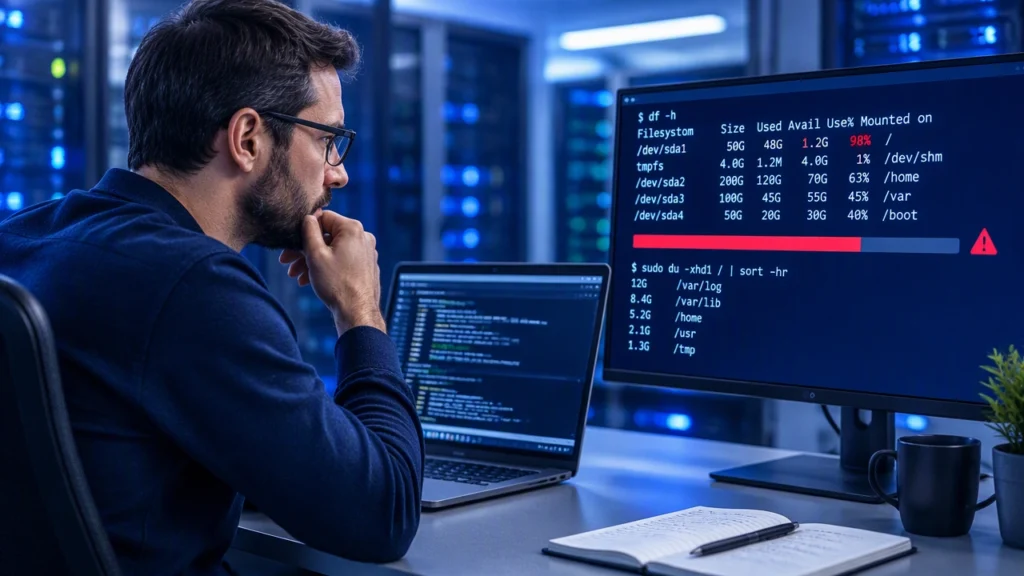
Hãy bắt đầu bằng việc xác nhận cảnh báo vẫn còn hiệu lực và bạn đang xem đúng mount point. Dùng df -h để xem mức sử dụng dung lượng trên tất cả filesystem đã mount. Chú ý cột Use% và đường dẫn Mounted on. Ngưỡng thường để bắt đầu điều tra là khoảng 85–95%, nhưng dấu hiệu kích hoạt ngay lập tức nên là bản thân cảnh báo và các triệu chứng như lỗi ghi, đăng nhập chậm hoặc lỗi ứng dụng.
Nếu môi trường của bạn dùng logical volume, hãy chạy thêm df -hT để thấy loại filesystem và xác minh xem đường dẫn bị đầy là một mount point riêng hay chỉ là thư mục nằm trong filesystem lớn hơn. Nhiều sự cố xảy ra chỉ vì dọn nhầm đường dẫn.
Loại trừ những nguyên nhân gây nhiễu phổ biến nhất
Trước khi truy tìm thư mục lớn, hãy loại trừ hai vấn đề thường gặp khiến filesystem trông như đã đầy dù không có file nào tăng kích thước rõ rệt.
- File đã xóa nhưng vẫn đang mở: Nếu một tiến trình vẫn giữ file đã xóa, dung lượng sẽ không được giải phóng cho đến khi handle được đóng. Kiểm tra bằng lsof +L1. Bạn có thể thấy các mục lớn được đánh dấu là deleted. Khởi động lại dịch vụ liên quan hoặc truncate file descriptor thường sẽ thu hồi dung lượng ngay lập tức.
- Cạn inode: Filesystem có thể đầy do hết inode chứ không phải hết block. Chạy df -i để kiểm tra mức sử dụng inode. Nếu cột Use% gần 100% trong khi mức sử dụng block trông vẫn bình thường, khả năng bạn đang có hàng triệu file nhỏ, thường nằm trong cache, spool hoặc thư mục tạm.
Tìm thư mục thực sự đang phình to
Khi đã xác nhận mount point nào bị đầy, bước tiếp theo là Tìm thư mục gây đầy ổ đĩa trên Linux. Hãy bắt đầu từ trên cao rồi đi xuống dần. Từ thư mục gốc của mount point bị ảnh hưởng, chạy du -h –max-depth=1 để xem tổng dung lượng của các thư mục cấp cao nhất. Nếu cần, hãy sắp xếp kết quả hoặc đưa qua pager để dễ đọc hơn.
Sau đó đi sâu từng cấp một vào những thư mục lớn nhất. Ví dụ, nếu /var lớn, hãy kiểm tra /var/log, /var/tmp và /var/lib. Tiếp tục thu hẹp cho đến khi thấy một thư mục chiếm phần lớn mức tăng. Tại thời điểm đó, hãy liệt kê các file lớn nhất bằng ls -lhS hoặc find . -maxdepth 2 -type f -size +100M -exec ls -lh {} ; để xác định chính xác file.
Cách tiếp cận này an toàn và nhanh hơn nhiều so với việc xóa hàng loạt. Nó cũng cung cấp bằng chứng để bạn chia sẻ trong bản ghi thay đổi hoặc ticket sự cố.
Kiểm tra các điểm nóng thường tăng dung lượng
Nếu bạn chưa biết nên xem ở đâu trước, hãy tập trung vào những đường dẫn thường tăng nhanh trong môi trường production:
- Log: /var/log, log ứng dụng và log container trong /var/lib/docker/containers hoặc /var/lib/containerd. H��y tìm mức log debug quá chi tiết, lỗi lặp lại hoặc các file đã xoay vòng nhưng không được nén.
- Cache gói và image: Trên Debian hoặc Ubuntu là /var/cache/apt/archives. Trên RHEL hoặc Fedora là /var/cache/dnf. Trên hệ thống có Snap là /var/lib/snapd/cache. Trên máy chủ container, các image và layer không dùng đến có thể tích lũy rất nhanh.
- Dữ liệu tạm: /tmp và /var/tmp có thể tích tụ sau các job, bản build hoặc upload bị lỗi.
- Dữ liệu người dùng và bản sao lưu: Thư mục home và các bản sao lưu thủ công trong /opt hoặc /srv là nguyên nhân phổ biến trong môi trường nhỏ.
- Log journal: Nếu bạn dùng systemd, journalctl –disk-usage có thể cho thấy journal chiếm dung lượng lớn bất ngờ và cần giới hạn kích thước.
Sử dụng các bước dọn dẹp an toàn
Sau khi xác định được mục tiêu, hãy dọn dẹp một cách có kiểm soát. Với log, hãy ưu tiên truncate thay vì xóa nếu file đang được service giữ mở. Ví dụ, > /var/log/app/app.log sẽ giải phóng dung lượng mà không cần khởi động lại. Nếu bạn xóa một file log mà service vẫn đang ghi, dung lượng có thể không được giải phóng cho đến khi service được khởi động lại.
Với cache, hãy dùng chính lệnh dọn dẹp của trình quản lý gói. Với journal của systemd, hãy đặt giới hạn kích thước và vacuum các mục cũ. Với container, hãy xóa image không dùng và dọn build cache. Luôn xác minh sau mỗi bước bằng df -h và, nếu liên quan, df -i.
Tự động hóa và ngăn sự cố tái diễn
Xử lý sự cố dựa trên bằng chứng nên dẫn tới phòng ngừa. Hãy thêm giám sát cảnh báo cả mức sử dụng block và mức sử dụng inode cho từng mount point. Theo dõi xu hướng tăng trưởng của các thư mục quan trọng. Đặt chính sách xoay vòng log phù hợp với workload và rà soát lại sau mỗi sự cố. Nếu một dịch vụ liên tục làm đầy ổ đĩa, hãy điều chỉnh thời gian lưu giữ, giảm mức log chi tiết hoặc chuyển dữ liệu của nó sang volume riêng với giới hạn riêng.
Cuối cùng, hãy ghi lại mount point, thư mục bạn đã dọn và tiến trình gây ra tăng trưởng. Trong vận hành IT, giá trị của bản sửa lỗi sẽ được nhân lên khi nó có thể lặp lại và được mọi người hiểu rõ.